2026.04개인 프로젝트
Argos
AI 실시간 수업 분석 플랫폼
- 맡은 일
- Frontend 전담 (4개 역할 뷰 전체 구축)
- 기간
- 2026.04
- 소속
- 코리아IT 바이브코딩 공모전
- 수상
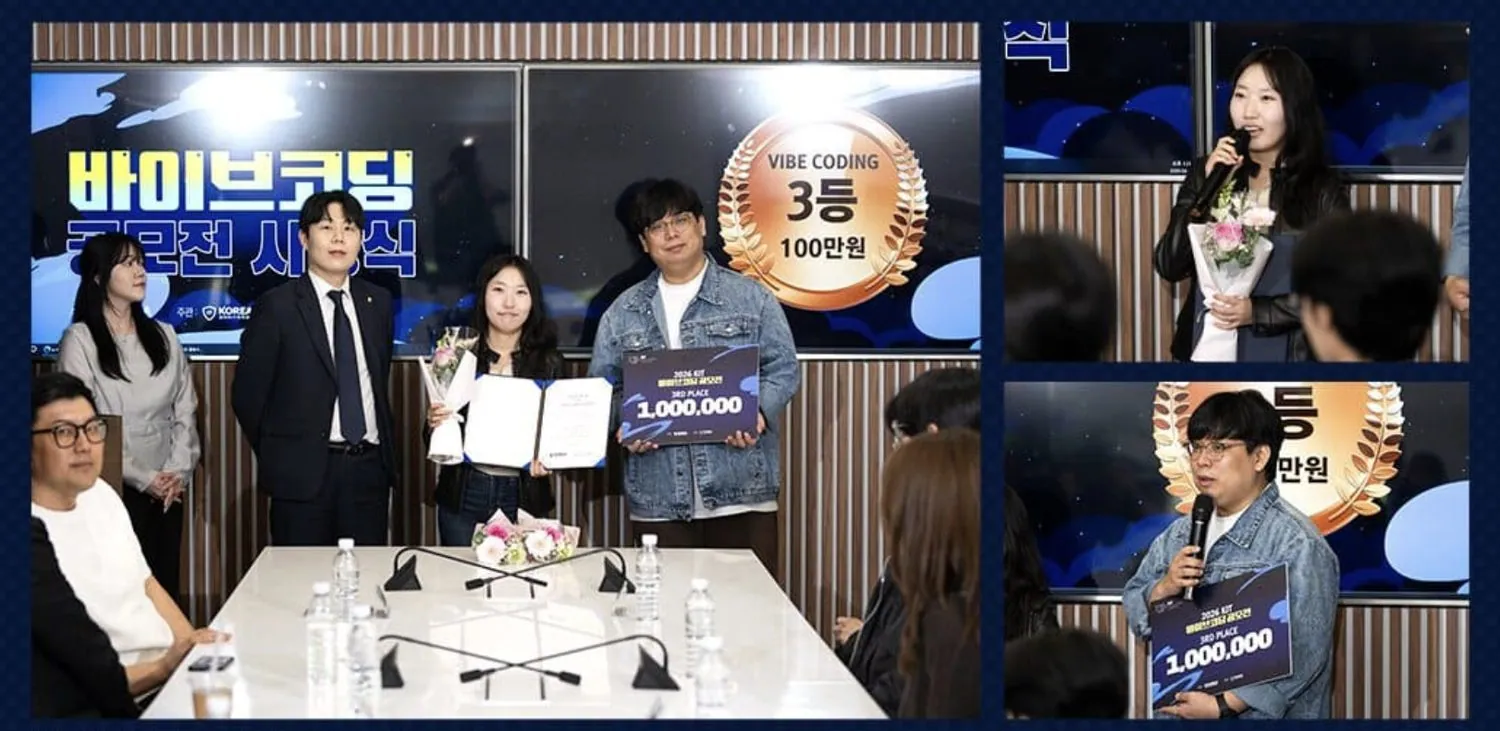
- 제1회 코리아IT아카데미 바이브코딩 공모전(KIT 해커톤) 장려상 — 500팀 중 3위
학원의 수업 품질을 데이터로 보는 플랫폼입니다. 수강 신청 단계에서 AI가 지원자 역량을 사전 진단하고, 수업 중에는 실시간 이해도를 히트맵으로 보여주며, 수업 후에는 개인별 리포트를 만들고, 운영 차원에서는 이탈 위험을 조기에 감지합니다.
강사·수강생·원장·멘토 네 역할이 각각 다른 화면을 쓰기 때문에 같은 데이터를 네 가지 관점으로 다시 그려야 했고, 저는 이 프론트엔드 전체를 맡았습니다. 코리아IT아카데미가 주최한 제1회 바이브코딩 공모전(KIT 해커톤)에 출품해 500팀 중 3위(장려상)로 수상했습니다.
바이브코딩 공모전이라 AI가 코드를 쓰는 건 전제였고, 제가 더 오래 고민한 건 그다음이었습니다 — AI가 짠 코드를 누가, 어떤 기준으로 믿을 것인가. 그래서 AI에게 맡기는 범위를 코드 작성에서 규칙·역할 분담·테스트·회고까지 넓히고, 그 전체를 Claude Code 설정과 문서로 고정해 매번 같은 방식으로 돌게 했습니다.
i.Problem
짧은 공모전 기간에 AI로 빠르게 만들수록, 무엇이 맞게 만들어졌는지 확인할 방법이 사라졌습니다. 에이전트는 매번 맥락을 잃고, 키를 클라이언트에 흘리거나 테스트를 통과시키려고 우회 코드를 넣는 일이 생길 수 있었습니다.
ii.Action
AI를 쓰는 방식 자체를 설계했습니다. CLAUDE.md에 절대 규칙 20개(보안·아키텍처·AI·코드 품질)를 두고, 권한 설정으로 위험한 명령을 막고, MCP(Context7·Supabase·Playwright)와 프로젝트 전용 커맨드 7개로 반복 작업을 정형화했습니다. 그 위에 planner·analyst·critic·dev·qa 역할을 나눈 에이전트 팀을 Cycle → Round 루프로 돌려, critic이 dev의 우회 수정을 막고 qa가 실패를 0이 될 때까지 다시 돌리게 했습니다.
iii.Result
테스트 케이스를 381건에서 1,024건으로 문서화하고 Playwright로 자동화해, Round 1의 실패 120건을 Round 2.5에서 실패 0 · flaky 0으로 만들었습니다. 결정과 맥락은 위키 73페이지로 남겨 다음 에이전트가 이어받게 했고, 500팀 중 3위(장려상)로 마무리했습니다.
핵심
- 01
제1회 코리아IT아카데미 바이브코딩 공모전(KIT 해커톤) 장려상
500팀 중 3위
- 02
AI 개발 파이프라인 설계
CLAUDE.md 절대 규칙 20개 · 권한 allow/deny · MCP 3종 · 전용 커맨드 7개로 AI 작업 방식을 고정
- 03
역할 분리 에이전트 팀
planner·analyst·critic·dev·qa가 Cycle → Round로 돌며 실패 120건 → 0, flaky 0 달성
- 04
프론트엔드 전담
약 16,000줄 기여, 강사·수강생·원장·멘토 4개 역할 뷰 전체 구축
나머지 5개 더 보기접기
- 05
실시간 이해도 히트맵
퀴즈 응답이 들어올 때마다 개념별 이해/미이해를 색으로 시각화
- 06
과목별 AI 역량 진단
정기 측정 결과를 레이더 차트로 시각화하고 역할별 화면에 연동
- 07
원장 경영 대시보드 5탭 + 멘토 이탈 방지 뷰 시각화 전면 개편
- 08
강사 AI 코칭 구조화
오개념 클러스터를 묶어 '어느 개념에서 몇 %가 약한지' 표출
- 09
Next.js 16 App Router + Supabase Realtime + Gemini, Zod로 AI 응답까지 전수 검증
자세히
궁금한 항목을 펼치면 그때 무엇이 문제였고 어떻게 판단했는지 나옵니다.
CLAUDE.md 절대 규칙 20개
API 키는 서버 전용, 새 테이블은 RLS를 같은 마이그레이션에, AI 프롬프트는 별도 폴더, AI 응답은 Zod 검증 필수, any·console.log·매직 넘버 금지. 에이전트가 바뀌어도 같은 기준으로 판단하게 했습니다.
권한 설정
빌드·테스트·git 조회 같은 반복 명령은 허용 목록에 두고, rm -rf · force push · reset --hard · DROP/TRUNCATE는 거부 목록으로 막아 AI가 되돌릴 수 없는 일을 못 하게 했습니다.
MCP 선별
Context7로 Next.js·Supabase·AI SDK 최신 문서를 조회하게 해 오래된 API를 쓰는 일을 줄이고, Supabase MCP로 마이그레이션·RLS를, Playwright MCP로 화면 검증을 맡겼습니다.
프로젝트 전용 커맨드 7개
데모 6단계 점검, 보안 감사, DB 마이그레이션, API 뼈대, AI 응답 테스트, 배포 전 점검, 스프린트 현황. 매번 말로 설명하던 절차를 한 줄 명령으로 바꿨습니다.
역할별 서브에이전트(AI 엔지니어·백엔드·DB 설계)를 따로 정의해, 한 에이전트가 모든 맥락을 들고 있다 흐려지는 일을 막았습니다.
planner(AC 정의) → analyst(현상 분석) → critic(비평·GO/NO-GO) → dev(수정) → qa(테스트 실행)로 역할을 나누고, Cycle은 목표 단위, Round는 '실패 → 수정 → 재실행' 단위로 돌렸습니다.
critic의 역할이 핵심이었습니다
테스트만 통과시키는 우회 수정을 거부하고 근본 원인 수정을 요구해, analyst가 놓친 멘토 권한 누락 3건을 포함한 Critical 9건을 잡았습니다.
테스트 케이스 381 → 1,024건(15개 화면, 역할 교차·RLS 시나리오 포함)을 문서화하고 Playwright로 자동화
Round 1 실패 120건에서 Round 2.5 실패 0 · flaky 0까지 반복했습니다.
한 번 나온 회귀(참여 코드 노출, 원장 RLS 격리 등 4건)는 회귀 테이블에 올리고 Playwright 스펙으로 고정해 다시 들어오지 못하게 했습니다.
결정과 맥락은 Karpathy Wiki 패턴의 위키 73페이지로 남겨, 새로 띄운 에이전트가 이전 대화 없이도 문서만 읽고 이어받게 했습니다.
배운 것
AI에게 맡기는 범위를 넓힐수록, 사람이 할 일은 줄어드는 게 아니라 '기준을 세우는 일'로 옮겨 간다는 걸 배웠습니다. 코드를 직접 쓰는 시간은 줄었지만, 무엇을 하면 안 되는지 · 무엇을 끝났다고 볼지를 글로 정해 두는 데 훨씬 많은 시간을 썼고, 그게 결과물의 품질을 정했습니다.
AI가 '됐다'고 말하는 것과 실제로 된 것은 다르다는 걸 여러 번 겪었습니다. 그래서 만드는 에이전트와 검증하는 에이전트를 나누고, 검증 쪽에 우회를 거부할 권한을 줬습니다. 사람 팀에서 리뷰어를 따로 두는 이유를 AI 팀을 꾸리면서 오히려 더 분명히 알게 됐습니다.
맥락은 대화가 아니라 문서에 남겨야 이어진다는 것도 배웠습니다. 에이전트는 새로 뜰 때마다 기억이 없어서, 규칙·결정·회귀 목록을 파일로 남겨 두는 것이 곧 인수인계였습니다. 이후 실무에서도 막혔던 문제를 글로 정리해 두는 습관이 여기서 붙었습니다.